
 Teenage Engineering diski açıkta dönen CD çalar çıkardıTeknoloji
 Billie Eilish 2027'de Hyde Park'ta sahneye çıkacakMüzik
 SonicWall Gen 6 güvenlik duvarları artık yama almayacakYazılım
 OpenAI'ın modeli AMD'nin yeni ekran kartını yüzde 14 iyileştirdiYapay zekâ
 Nolan'ın filmi Assassin's Creed Odyssey satışlarını artırdıOyun
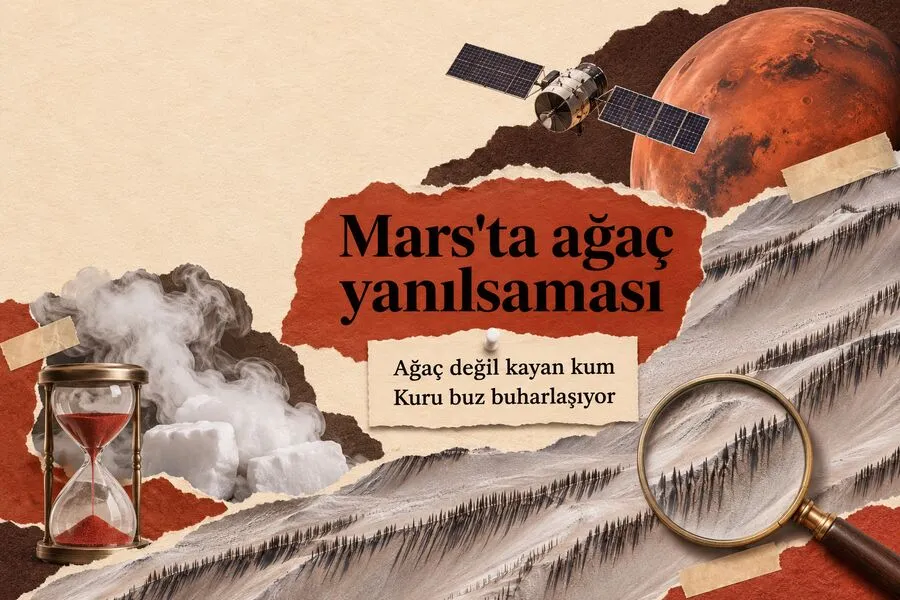 Mars'ın donmuş kumullarında ağaç yanılsamasıGenel

GitHub’ın paylaştığı bilgilere göre ReviewBench, GitHub’daki 103,9 milyon gerçek çekme isteğinin dil, depo boyutu ve çekme isteği boyutu dağılımlarına göre modellendi. Veri setindeki 219 çekme isteği, açık kaynak lisanslı 187 herkese açık depodan seçildi.
Dil ve depo boyutu dağılımları GitHub genelindeki dağılımlarla yakından eşleşecek şekilde tasarlandı. Çekme isteği boyutu dağılımında ise çok küçük, tek dosyalı değişikliklerin aşırı temsilini azaltmak için orta ve büyük boyutlu değişikliklere daha fazla ağırlık verildi.
Altın küme üç aşamada kuruldu
ReviewBench’teki her bulgu, önem derecesine ve kategoriye göre etiketlendi. Altın küme (ground truth) bulgularını oluşturmak için üç aşamalı bir süreç izlendi ve aynı temel sorunu işaret eden bulgular anlamsal olarak tekilleştirildi.
Altın küme aday bulguları, gerçek insan inceleyicilerden, yazarın sonraki commit’lerinden çıkarılan sorunlardan, deterministik analiz araçlarından ve farklı model ailelerinden birden fazla ileri seviye büyük dil modelinden toplandı. Bir bulgunun doğru kabul edilmesi için doğru, ilgili ve önemsiz olmayan (non-trivial) olması şartı arandı.
ReviewBench’te her değerlendirmede kullanılan veri seti, hakem ve eşleştirici birlikte sürümleniyor.
6 metrik, sürümlenen hakemle raporlanıyor
ReviewBench, bilinen ve yeni keşfedilen sorunları ölçmek için iki metrik ailesinde toplam 6 metrik raporluyor. “Grounded” metrikleri altın küme etiketlerine dayalı kesinlik, geri çağırım ve F1 skoru verirken, “augmented” metrikleri altın küme ile eşleşmeyen bulguları da değerlendirerek kesinlik, geri çağırım ve F1 skoru üretiyor.
Değerlendirmede büyük dil modeli hakem olarak Claude Sonnet 5 kullanıldı ve değerlendirme rubriği ile rubriği uygulayan hakem (judge) yayımlandı. ReviewBench’te her değerlendirmede kullanılan veri seti sürümü, hakem (judge) ve eşleştirici (matcher) birlikte sürümleniyor.
Web sitesi, liderlik tablosu ve gönderim
ReviewBench’in “research preview” sürümü ReviewBench web sitesi üzerinden erişime açıldı. Sitede tam performans testi incelenebiliyor, kod inceleme ajanları karşılaştırılabiliyor ve kullanıcı kendi ajanını değerlendirip sonuç gönderebiliyor.
ReviewBench veri setinin tamamı da herkese açık olarak yayımlandı. Çekme istekleri, bulgular, etiketler, önem derecesi ve kategori anotasyonları veri setinde yer alıyor. Tam veri setiyle değerlendirilen kod inceleme ajanlarının sonuçları ortak bir liderlik tablosunda yayımlanıyor ve kullanıcı tercihleri değiştikçe liderlik tablosu buna göre yeniden sıralanıyor.
Bu yazı hakkında ifade bırakın
OHA!falan’ı takip edinGünün haberleri, kısa videolar ve özetler her gün sosyal medyada.

Mert A.ohafalan editörü
Sürümleri, araçları ve geliştirici tarafını izler. Neyin bozulduğunu ve neyin kolaylaştığını ayrı ayrı yazar.
 Terbiyeli Sulu Köftekişi başı ~124 ₺ · 60 dk
 Lahmacunkişi başı ~91 ₺ · 65 dk
 Fırın Makarnakişi başı ~55 ₺ · 50 dk
İlginizi çekebilir
Ele geçirilen 4.800 GitHub hesabıyla 61 bin depo yoklandı, wfx-loot saldırısı bulut anahtarlarını çaldı
Aikido araştırmacılarına göre wfx-loot adlı kampanyada saldırgan, çalıntı kimlik bilgileriyle ele geçirdiği 4.837 GitHu…
GitHub, saniyede 7.200 push işleyen yeni Git depolama mimarisini anlattı
GitHub, Universe etkinliğinde duyurduğu ve Rubicon adını verdiği yeni Git depolama mimarisinin ayrıntılarını paylaştı. …
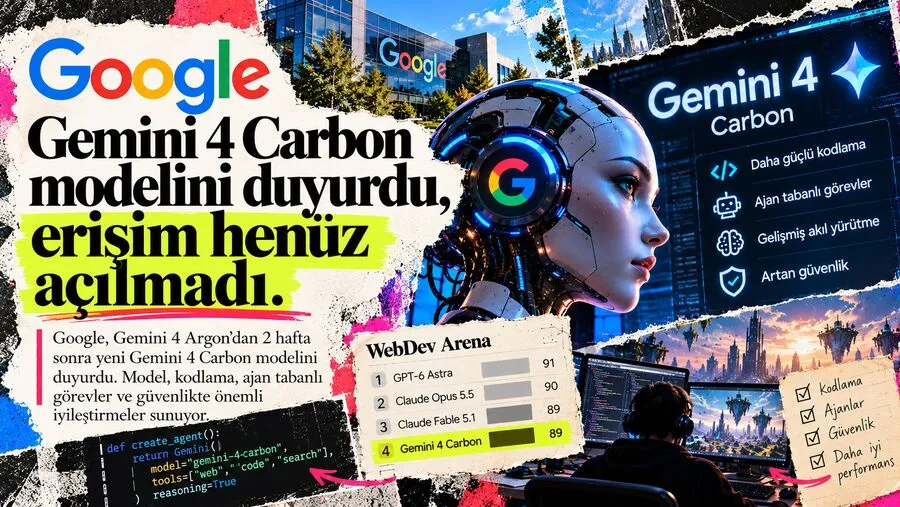
Google, Gemini 4 Carbon modelini duyurdu, erişim henüz açılmadı
Google, Gemini 4 Argon’u yayımlamasından 2 hafta sonra Gemini 4 Carbon adlı yeni öncü yapay zekâ modelini duyurdu. Şirk…
